Présentation du projet IJRAP labs (rap journalisme et Investigation)

Bonjour à tous. Je développe le projet IJRAP labs, un logiciel Open Source pour le collecte des données scientifiques directement sur le terrain en mode déconnecté (offline).

L’outil cible l’écosystème python et le framework kivy pour sa capacité cross Platforms (Android et ordinateur). Le projet est enregistré sur zenodo pour garantir son cadre scientifique et open source.

Je vous invite tous a rejoindre cette coproduition. Si vous souhaitez consulter la fiche zenodo ou échanger sur le code, contacter moi en message privé et je vous partagerai le lien direct.

Il faudrait nous en dire plus (liens, descriptions, exemples, photos/images) parce que là ça nous laisse un peu sur notre faim.

Bonjour debnet, Bonjour à tous

Merci pour ton retour bienveillant ! C’est tout à fait légitime, mon premier message manquait de concret. Pour lever le mystère et ne plus vous laisser sur votre faim, voici les éléments tangibles du projet IJRAP (qui signifie très exactement : Investigation Journalisme RAP).

Le but de cette méthodologie est de transformer le rappeur, l’étudiant, le citoyen ou le lanceur d’alerte en un véritable chercheur empirique. Elle utilise la structure du rythme et de la vidéo synchronisée comme canaux d’expression universels pour diffuser des investigations journalistiques ultra-sourcées et certifiées conformes.

Pour analyser la rigueur scientifique et la structure du projet, vous pouvez consulter mes deux liens:

Le rôle de Python dans IJRAP Labs

C’est à travers ma branche technique (IJRAP Studio) que Python intervient. Je veux développer des outils open-source pour automatiser et sécuriser ma chaîne de production :

1. Préservation des preuves (Investigation) : Développer des scripts Python capables de capturer des sources web en temps réel et de calculer instantanément leur empreinte cryptographique (SHA-256). Cela permet de garantir l’intégrité absolue des faits face aux manipulations par IA.

2. Traitement des dossiers (Journalisme) : Utiliser le traitement de texte (Parsing, NLP) pour structurer les données brutes (budgets publics, registres officiels) et vérifier rigoureusement que chaque affirmation textuelle est liée à des sources vérifiables.

3. Aide à la synchronisation (Rap) : Créer des outils pour automatiser le chapitrage audio, vidéo, afin de faire apparaître à l’écran la preuve visuelle (document, contrat) au moment exact où elle est prononcée oralement.

Le cadre théorique est validé sur Zenodo, mais les outils logiciels sont en pleine co-construction. Si certains d’entre vous ont des conseils sur l’architecture, la cryptographie ou le scraping sécurisé en Python, je serais ravi d’échanger avec vous !

Le projet semble vraiment intéressant ! Vous avez un discord ou truc du genre ?

Bonjour asyd, et bonjour à tous,

Merci beaucoup pour votre intérêt envers le projet !

Nous n’avons pas encore de serveur Discord dédié, car ces infrastructures communautaires sont en cours de déploiement. En attendant, j’invite toute personne intéressée par une collaboration ou par le code du projet à me contacter directement par e-mail à l’adresse ijraplabs@proton.me afin que nous puissions échanger.

Pour des raisons de sécurité, de traçabilité et de protection des données liées à notre démarche d’investigation, l’accès à nos livrables et aux informations névralgiques du projet s’effectue obligatoirement sous réserve de confidentialité (NDA).

Au plaisir de collaborer et de discuter avec vous !

Pour de la collecte hors ligne avec Kivy, une base SQLite locale sur le téléphone qu’on synchronise plus tard vers un serveur marche plutôt bien, et ça évite de réinventer un format de fichier. Vous avez prévu quoi pour les conflits quand deux personnes modifient la même fiche sans réseau ? C’est souvent là que ça se complique.

Bonjour et merci beaucoup pour ce retour très pertinent !

C’est effectivement le point sensible sur les architectures déconnectées. Pour le projet IJRAP Media labs, la modification d’une fiche ne repose pas uniquement sur du texte brut : notre approche est tripartite. Chaque action clé est liée à des fichiers médias (photo, vidéo, audio) capturés sur le terrain. Même hors connexion, le smartphone intègre des métadonnées matérielles infalsifiables à ces fichiers : la géolocalisation GPS et l’horodatage précis. Lors de la synchronisation, le serveur compare ces métadonnées physiques pour arbitrer automatiquement et valider la donnée la plus authentique. Cette automatisation est parfaitement réalisable.

Afin de structurer nos échanges de manière professionnelle, accessible et sécurisée à long terme (et pour éviter les contraintes d’accès de Discord ou Telegram), j’ai créé notre espace de travail officiel sur WhatsApp sous forme de Communauté (où les numéros de téléphone des membres restent totalement masqués pour protéger la confidentialité de chacun).

J’invite tous les développeurs intéressés par le code Python/Kivy ou par une collaboration sur le projet à nous rejoindre directement sur notre communauté via ce lien :

Au plaisir d’échanger et de construire ce projet avec vous sans aucune contrainte !

La Direction — IJRAP Media labs

sur les serveurs de facebook. En toute confiance donc :wink:

Bonjour Chadys et merci pour ton retour !

Tu as totalement raison concernant WhatsApp et Meta, l’ironie est tout à fait méritée. C’est un choix purement temporaire pour le lancement.

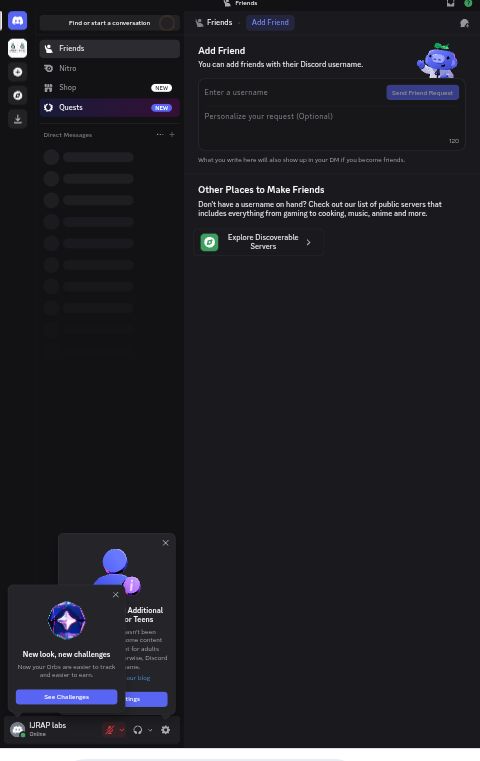
Mon objectif initial était de centraliser nos échanges sur Discord pour garantir une discussion mieux structurée et sécurisée à long terme. Malheureusement, je rencontre actuellement un blocage technique : mon compte attend une validation d’âge automatique (le robot refuse de valider ma carte d’identité via l’appareil photo, comme on peut le voir sur ma capture d’écran). Je fais le nécessaire pour régler ce problème le plus tôt possible, et mon espace Discord sera bientôt pleinement fonctionnel. En attendant, les utilisateurs extérieurs ont du mal à me joindre de manière fluide.

Si un espace de discussion interne ou officiel est possible directement sur la plateforme de l’AFPy dans l’intervalle, j’en serais extrêmement reconnaissant. Cela nous permettrait de sécuriser nos travaux dès maintenant et de bénéficier au mieux de vos conseils et de votre expertise d’administrateurs sur le projet.

Pour ceux qui souhaitent aller plus loin et découvrir la structure de notre recherche, le projet IJRAP Media s’appuie sur une méthodologie tripartite stricte.

Sur le plan de l’ingénierie (développée sous Python), notre suite logicielle intègre un Protocole Anti-Fraude basé sur la fusion croisée de 4 empreintes numériques synchronisées (Audio, Photo, Vidéo, Écrit) scellées par un hachage cryptographique SHA-256. L’objectif est de garantir une chaîne de contrôle inviolable pour les données d’intérêt public.

Notre cadre méthodologique complet et son manifeste sont officiellement enregistrés et consultables au sein du dépôt académique international Zenodo (Record : 23139273). Je serais ravi de partager le fichier de la feuille de route avec les administrateurs ou les développeurs intéressés par l’implémentation de ces filtres logiques !

Au plaisir de vous lire !

Le problème soulevé : Comment l’application IJRAP labs gère-t-elle les conflits sur la base de données SQLite si deux journalistes travaillent hors ligne (sans réseau) et modifient la même fiche d’enquête ? Est-ce que les données du second risquent d’écraser celles du premier lors de la synchronisation ?

La solution : Le système n’écrase rien car il ne fusionne pas les fichiers. Chaque appareil génère un enregistrement unique et inviolable fondé sur ses propres métadonnées (médias, GPS, horodatage). Les deux travaux sont conservés sur le serveur pour enrichir l’enquête sous différents angles. Le premier connecté obtient légitimement la primauté du scoop.

**

Imaginons un bombardement ou une manifestation sur une place publique à un instant T. Deux journalistes de votre équipe sont sur place sans réseau Internet.

• Le Journaliste A se trouve au nord de la place. Il enregistre une vidéo du bâtiment touché, prend un mémo vocal et écrit un court résumé.

• Le Journaliste B se trouve au sud de la place. Il prend des photos des débris au sol et rédige ses constatations.

Ce qui se passe lors du retour du réseau :

1. Pas de conflit d’écriture : Bien qu’ils décrivent le même événement, l’application attribue un identifiant unique à l’appareil du Journaliste A et un autre au Journaliste B.

2. Le Scoop : Le Journaliste A trouve du réseau en premier. Ses médias (vidéo + audio) et son texte sont immédiatement publiés sur le serveur. Il valide le scoop.

3. Le Complément d’enquête : Le Journaliste B trouve du réseau 10 minutes plus tard. Le serveur détecte que ses coordonnées GPS et son horodatage correspondent au même événement. Au lieu d’effacer le travail du Journaliste A, le système ajoute ses photos et son texte à l’enquête globale.

Résultat : La vérité est renforcée de manière inviolable par deux angles de vue différents, sans qu’aucune information ne soit perdue ou falsifiée.

Merci beaucoup pour vos interventions qui contribuent directement a l’amélioration du logiciel(application). Le point essentiel sera le moment d’essai sur tous les aspects disponible pour évaluer ou éliminer les bugs, les insatisfactions, les enquêtes classique ou l’appareil doit être sur veilleuse sans s’arrêter d’enregistrer, la perte de l’appareil ou la saisie de l’appareil sur des terrains redoutables.

Directeur IJRAP Media

Tu redis souvent les mots “inviolable” et tu parles de hachage cryptographique aussi. Tu peux en dire plus ? Tu t’appuies sur quoi comme librairie ? pourquoi est-ce “inviolable” ?

Ah, et pour rebondir sur la remarque de @chadys , quitter facebook pour Discord, je suis pas sûr du bon choix non plus…

Bonjour Mindiell,

Merci pour tes questions légitimes. Tu as totalement raison de me challenger sur les termes “inviolable” et “hachage”, l’abus de langage est vite arrivé !

Pour être tout à fait transparent : nous ne parlons pas ici d’un logiciel déjà conçu ou figé. Nous sommes actuellement en pleine phase d’essais et de prototypage avec Kivy au sein d’IJRAP Labs.

Mon rôle actuel est de formuler l’essentiel des besoins et des concepts de sécurité pour que les scientifiques, cryptologues et développeurs puissent ensuite les adapter, les coder et les intégrer selon les règles de l’art. L’objectif de nos essais actuels avec Kivy est simplement de valider la faisabilité de ces idées face aux réalités et contraintes strictes du terrain (mode déconnecté, infrastructures limitées).

Nous sommes conscients que pour protéger cette œuvre sur le long terme face aux menaces technologiques futures, cette architecture devra être validée par des pairs. C’est précisément pour cela que je viens échanger avec vous sur l’AFPy.

Au moment opportun, tout le projet passera sur les plateformes de référence et les protocoles validés par des experts comme vous. Notre but est d’aboutir à un travail bien fait, hautement sécurisé, pour servir le monde entier.

Pour préciser l’orientation de nos essais actuels :

  1. Sur les outils testés :
    Pour poser les bases de la méthode de sécurité, nos essais se concentrent sur la bibliothèque standard de Python : hashlib (SHA-256) pour tester la garantie d’intégrité des fichiers (audio, vidéo, texte) dès leur capture, afin de prouver qu’une preuve journalistique n’a pas été altérée.

  2. Concernant Discord vs Facebook :
    Ta remarque et celle de @chadys sont très justes. Passer de Facebook à Discord ne fait que déplacer le problème vers une autre plateforme propriétaire et centralisée. C’est un canal transitoire. À terme, le projet s’appuiera sur des solutions de communication totalement souveraines et décentralisées (comme Matrix ou des protocoles P2P).

Puisque je formalise actuellement le cahier des charges technique pour les scientifiques qui vont développer le cœur du système, quelles seraient, selon vous, les bibliothèques Python et les architectures de sécurité incontournables à inscrire dans nos spécifications ?

Résumé de l’architecture de sécurité IJRAP labs

L’architecture vise à garantir la sécurité des données collectées sur le terrain (gouvernement, santé, défense) grâce à un mécanisme d’ancrage sur la Blockchain et un stockage décentralisé/souverain. Le système fonctionne en mode “Zero-Knowledge” (chiffrement de bout en bout avant l’envoi) et assure une détection des altérations à 100 %.